
ようこそ、未来のオブザーバビリティ・マスターたち! 👋
今日のテーマは、モダンな監視システムの代名詞とも言える Prometheus だ。君たちも、日々の運用で「このシステム、ちゃんと動いてるかな?」「なんか怪しい動きをしていないかな?」と不安になった経験、きっとあるはず。そんな悩みを解決し、システムの状態を「見える化」してくれるのが Prometheus なんだ。
この記事では、Prometheus の基本概念から、どうやってメトリクスを収集するのか、そして実際に動かすまでを、まるで隣で教えるかのように、優しく丁寧に解説していくよ。これをマスターすれば、君たちの毎日の作業は劇的に楽になるはず。さあ、一緒にオブザーバビリティの世界への第一歩を踏み出そう!
—
1. Prometheusとは何か?概要と特徴をわかりやすく解説
まず、Prometheus って一体何者なんだろう?
一言でいうと、Prometheus は 時系列データベース(Time Series Database, TSDB) を中心とした、オープンソースの監視システム なんだ。
「時系列データベース?」って思ったかもしれないね。これは、「いつ、どんな値だったか」 という情報を、時間の経過とともに記録していくデータベースのこと。例えば、「CPU使用率が、10:00:01 に 30%、10:00:02 に 31%、…」というように、データが時間順に並んでいるイメージだ。
Prometheus の最大の特徴は、その 「プル型(Pull型)」アーキテクチャ と、「メトリクス」 という概念をうまく使って、システムの状態を詳細に把握できること。
Prometheus の主な特徴:
- プル型(Pull型)アーキテクチャ: これが Prometheus の一番のキモ!後で詳しく解説するけど、Prometheus 自身が監視対象のサービスから定期的にデータを「取りに行く」方式なんだ。
- 多次元データモデル: メトリクスには、名前だけでなく、キーと値のペア(ラベル)をたくさん付けることができる。これにより、「どのサーバーの」「どのCPUコアの」「どのプロセスにおける」CPU使用率、といったように、非常に詳細な情報を記録・クエリできるんだ。
- PromQLという強力なクエリ言語: 記録されたメトリクスを、柔軟かつパワフルに分析・集計するための言語がある。これで、「過去5分間の平均CPU使用率が70%を超えたサーバーを全てリストアップ」とか、「エラーログの発生頻度が急増しているサービスを特定」といった高度な分析ができるようになる。
- 豊富なエクスポーター: Prometheus は、標準で色々なサービス(Node.js、Docker、Kubernetesなど)からメトリクスを収集するための仕組みを持っている。さらに、自分でカスタムエクスポーターを作ることも可能だ。
- アラート機能: 設定した閾値を超えた場合などに、アラートを発報する機能も備わっている。
「プル型」と「メトリクス」については、これからじっくり見ていくから、今は「Prometheus は、時間とともに変化するシステムの状態を、詳細な情報(ラベル)とともに記録・分析できるすごいヤツなんだな」くらいに思っておいてくれればOKだ。
—
2. プル型(Pull型)アーキテクチャのメリット・デメリット
さて、Prometheus の心臓部とも言える「プル型アーキテクチャ」について掘り下げてみよう。
プル型アーキテクチャとは?
これは、Prometheus サーバーが 「監視対象のサービス」から、定期的にメトリクスデータを「取りに行く(Pullする)」 という方式のこと。
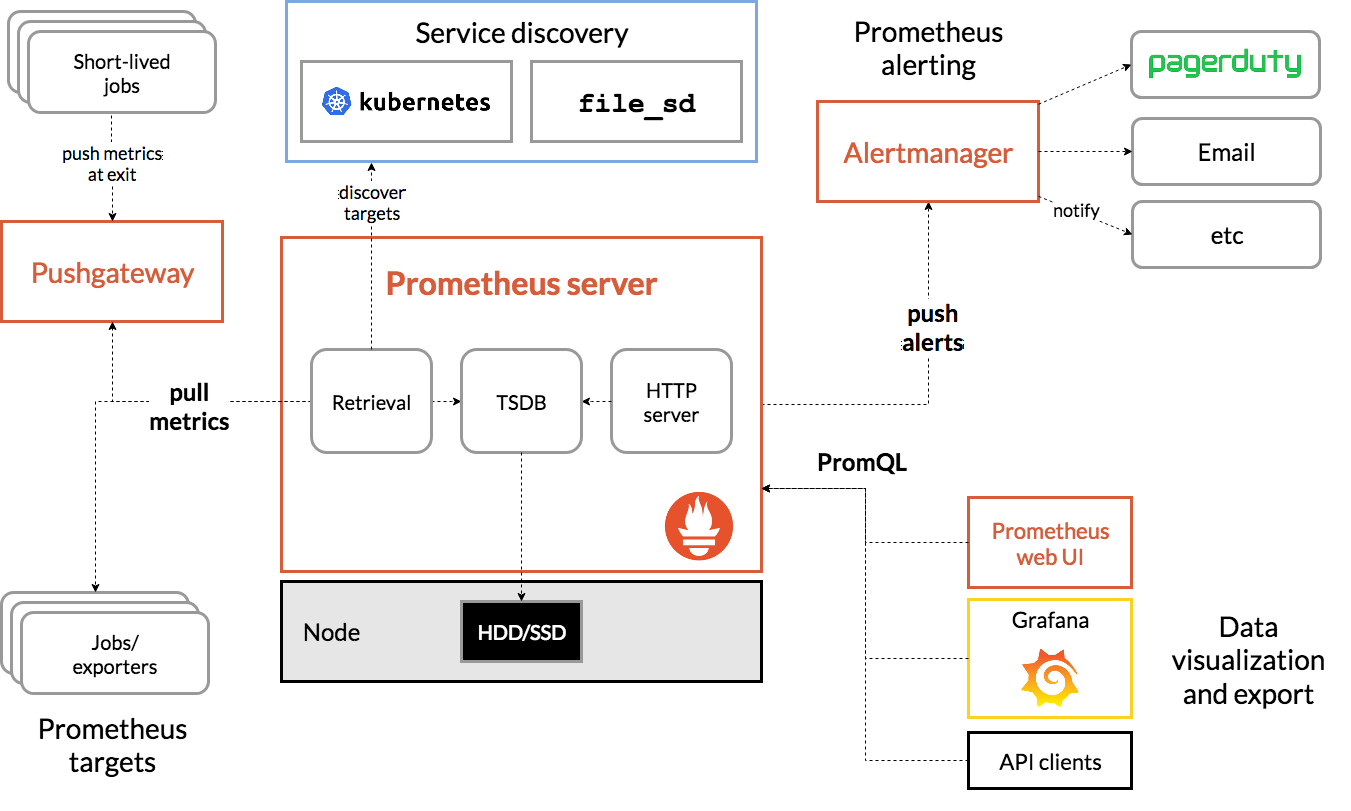
(画像出典: Prometheus公式ドキュメント)
図で言うと、Prometheus サーバーが真ん中にいて、そこから矢印が各ターゲット(監視対象)に向かっているイメージだ。
プル型のメリット:
1. ターゲット側での設定が最小限で済む: 監視対象のサービスは、Prometheus がアクセスできるエンドポイント(通常は `/metrics` というURL)を用意しておくだけで良い。こちらから積極的にデータを送りつける必要がないから、実装の負担が少ないんだ。
2. ネットワークの制御がしやすい: 外部から監視対象へのアクセスを許可するだけで済む。逆に、監視対象から外部への通信を許可する必要がないため、セキュリティ的にも有利な場合がある。
3. ターゲットの生死を自動的に検知: Prometheus は定期的にターゲットにアクセスするので、ターゲットがダウンした場合は、そのアクセスが失敗することで「死活監視」のような役割も兼ねてくれる。
4. データの一貫性が保ちやすい: Prometheus 側で一元的にデータ収集のタイミングを管理できるため、収集されるデータのタイムスタンプに大きなズレが生じにくい。
プル型のデメリット:
1. ファイアウォール設定が必要: Prometheus サーバーから監視対象へのネットワーク通信を許可する必要がある。多数のサービスを監視する場合、ファイアウォールルールの管理が煩雑になる可能性も。
2. ネットワークの遅延やパケットロスに弱い: Prometheus がデータを取得する際にネットワークの問題があると、データの取得が失敗したり、遅延したりする可能性がある。
3. ターゲットの負荷: 多数のターゲットを監視している場合、Prometheus サーバー自体への負荷はそれほど大きくないが、各ターゲットは Prometheus からのスクレイピング(データ収集)リクエストに応答する必要がある。
【先輩からのひとこと】
「プッシュ型(Push型)」、つまり監視対象が Prometheus にデータを「送りつける」方式のツールもあるんだ。でも、Prometheus がプル型を採用しているのには、上記のようなメリットがあるからなんだよ。特に、ターゲット側の負担を減らしつつ、システムの状態を詳細に把握できる点が大きいんだ。
—
3. メトリクスの4つの基本タイプ(Counter, Gauge, Histogram, Summary)
Prometheus では、システムの状態を数値データとして記録することを 「メトリクス(Metrics)」 と呼ぶ。そして、そのメトリクスには、データの性質に応じていくつかの種類があるんだ。ここでは、最も基本となる4つのタイプを紹介しよう。
1. Counter(カウンター)
「増加し続ける、またはリセットされる単調な値」 を表すメトリクスだ。
例:
- HTTPリクエストの総数
- エラーの総数
- 処理されたバイト数
Counter は、一度増加したら減ることはない。ただし、サービスが再起動した場合などに、値が 0 にリセットされることがある。
Prometheus では、この Counter の「増加量」を計算して、単位時間あたりのレート(例: 1秒あたりのリクエスト数)を求めることが多い。
PromQLでの例:
HTTPリクエストの総数を数えるメトリクス http_requests_total の
1秒あたりの平均リクエスト数を計算
rate(http_requests_total[5m])
`rate()` 関数は、指定した期間(ここでは5分間 `[5m]`)における Counter の増加量を計算してくれる、とっても便利な関数なんだ。
2. Gauge(ゲージ)
「任意の値をとりうる、現在値」 を表すメトリクスだ。
例:
- 現在のCPU使用率 (%)
- 現在のメモリ使用量 (MB)
- キューの長さ
- 温度
Gauge は、時間とともに増加したり減少したりする。常に最新の状態を知りたい場合に使う。
PromQLでの例:
現在のCPU使用率が80%を超えているプロセスをリストアップ
process_cpu_usage_seconds_total{job=”my_app”} > 0.8
(※実際には、Gauge で CPU 使用率を表現する場合、`process_cpu_usage_seconds_total` のような Counter を使って計算することが多いですが、ここではGaugeのイメージを掴むために例示しています。より正確には `process_cpu_seconds_total` の `rate()` を使うのが一般的です。)
3. Histogram(ヒストグラム)
「観測された値の分布(度数分布)」 を表すメトリクスだ。
例:
- リクエストの処理時間
- レスポンスサイズ
Histogram は、指定した範囲(バケット)にどれくらいのデータが収まったかを数える。例えば、「処理時間が0.1秒未満が100件、0.5秒未満が250件、1秒未満が300件…」といった具合だ。
この Histogram を使うと、平均値だけでなく、90パーセンタイル値(「観測値の90%がこの値以下である」という値)のような、より詳細な分布情報を得ることができる。これは、システムのパフォーマンスを分析する上で非常に重要だ。
Prometheus では、Histogram は通常、以下の3つのメトリクスとして観測される:
- `{le=”
“}`: 指定したバケットの上限値(Less than or Equal to)以下の観測値の合計数 - `{le=”+Inf”}`: 全ての観測値の合計数(Counterとしても機能する)
- `_count`: 全ての観測値の合計数(`+Inf` と同じ)
- `_sum`: 全ての観測値の合計(正確な合計値)
PromQLでの例:
リクエスト処理時間の90パーセンタイル値を計算
histogram_quantile(0.90, sum(rate(http_request_duration_seconds_bucket[5m])) by (le))
`histogram_quantile()` 関数は、Histogram のデータから指定したパーセンタイル値を計算してくれる。
4. Summary(サマリー)
Histogram と似ているが、Summary は 「観測された値」と「その値のパーセンタイル値」を直接記録 するメトリクスだ。
例:
- リクエストの処理時間(パーセンタイル値を含む)
Summary は、クライアント側(メトリクスを生成するアプリケーション側)でパーセンタイル値を計算して送信する。
Histogram はサーバー側で集計するため、より柔軟な分析が可能だが、Summary はクライアント側の実装に依存する。
PromQLでの例:
リクエスト処理時間の90パーセンタイル値を取得
http_request_duration_seconds{quantile=”0.90″}
【先輩からのひとこと】
最初は Counter と Gauge の違いをしっかり理解することが大事。Histogram と Summary は、より高度な分析をしたいときに使うもの。まずは、君たちが開発しているアプリケーションで、どんなメトリクスを収集すればシステムの振る舞いを把握できるか、考えてみてほしい。例えば、「エラーの発生回数」は Counter、「メモリ使用量」は Gauge、「リクエストの応答時間」は Histogram で収集すると、システムのボトルネックが見えやすくなるよ。
—
4. まとめ:今日から始めるオブザーバビリティの第一歩
さて、Prometheus の基本概念、プル型アーキテクチャ、そしてメトリクスの4つの基本タイプについて解説してきたけど、どうだったかな?
Prometheus は、その強力な機能と柔軟性で、現代の複雑なシステムを監視するためのデファクトスタンダードになりつつある。今回紹介した内容は、まさにその入り口だ。
今日から始めること:
1. Prometheus をインストールしてみよう!
Docker を使うのが一番手軽だよ。公式の Docker イメージがあるので、数行の設定で起動できる。
(※具体的なインストール手順は、今回は省略するけど、公式ドキュメントや日本語の入門記事がたくさんあるから、ぜひ調べてみてね!)
2. まずは Node Exporter を動かしてみよう!
Node Exporter は、サーバーの CPU、メモリ、ディスク、ネットワークといった基本的なシステムメトリクスを収集してくれる公式エクスポーターだ。これを Prometheus に収集させることで、君のサーバーの状態がリアルタイムで見えるようになる。
3. PromQL で遊んでみよう!
Prometheus の Web UI から、収集されたメトリクスに対して PromQL を実行できる。まずは `up` メトリクス(ターゲットが稼働しているかを示す)や、Node Exporter が収集したメトリクス(`node_cpu_seconds_total` など)を `rate()` 関数で集計してみると、PromQL の面白さがわかるはずだ。
オブザーバビリティ(Observability)とは、システムの状態を外部からどれだけ正確に把握できるか、ということ。Prometheus を使いこなすことは、そのオブザーバビリティを高めるための強力な武器になる。
最初は少し難しく感じるかもしれないけれど、一つ一つ理解していけば、きっと君たちの開発・運用ライフを劇的に変えてくれるはずだ。
さあ、今日から君も Prometheus と一緒に、システムの「見える化」を始めよう! これからも、君たちのエンジニアリングライフがより豊かになるような、現場で震えるほど役立つ知見をどんどん発信していくから、楽しみにしていてほしい。
もし、この記事を読んで「もっと知りたい!」「こんなことが知りたい!」ということがあれば、気軽にコメントで教えてくれると嬉しいよ。
それでは、また次の記事で会おう! 👋